

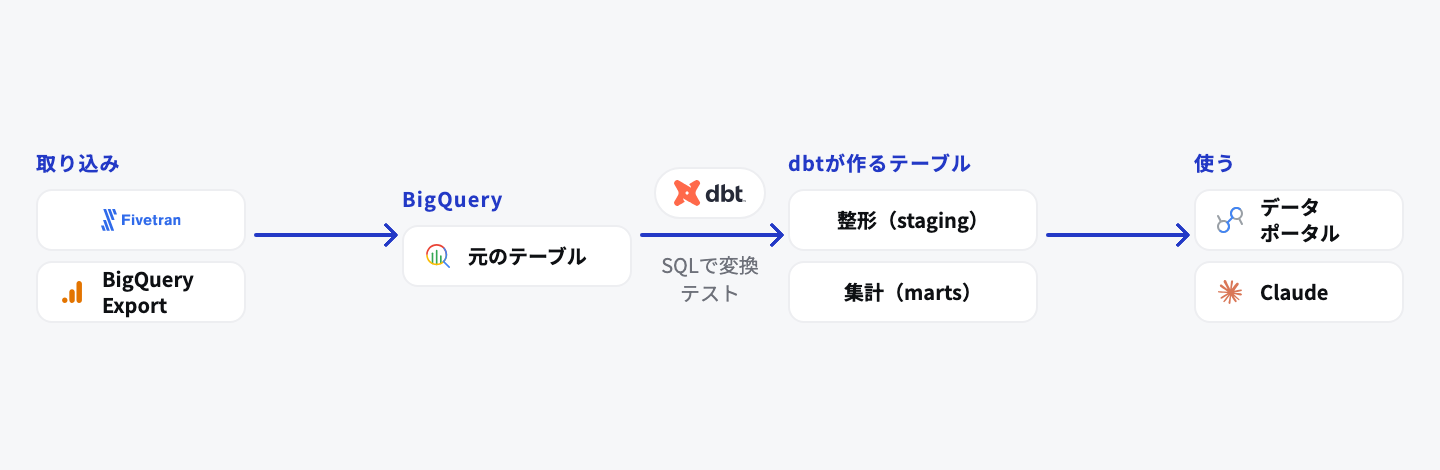
dbtは、BigQueryなどのデータウェアハウス(DWH)にあるデータを、分析に使える形に変換するツールです。変換の中身はSQLのSELECT文で書き、表どうしの依存関係、テスト、ドキュメントをまとめて管理します。
データを集めて保管場所の中で変換する「ELT」のうち、T(変換)を担います。ETLとELTの違いは「ETL・ELTとは(別タブで開く)」で解説しています。
2026年は、dbtにとって大きな変化の年でした。6月1日にFivetranとdbt Labsの合併が完了し、9月にはRustで作り直した新しい世代の「dbt v2」が正式版になりました(dbt Summit 2026の発表(別タブで開く))。これに合わせて、製品の名前も変わっています。
本記事では、dbtでできること、今の製品の名前と料金、Dataformとの違い、BigQueryでの始め方を解説します。記載の仕様と料金は2026年10月時点の公式情報に基づきます。
dbtとは
dbt Labsは、dbtを「DWHの元のデータを、信頼できるデータの製品に変換する」ものと説明しています。利用者は簡単なSQLのSELECT文を書き、難しい処理はdbtが引き受けるとしています(What is dbt?(別タブで開く))。
なお、英語で「DBT」と書くと、心理療法の一種(弁証法的行動療法)を指すこともあります。データの分野でdbtと言う場合は、本記事で扱うツールのことです。
なぜ変換をツールで管理するのか
広告やGA4、CRMのデータをDWHに集めただけでは、すぐには分析に使えません。媒体ごとに列の名前が違う、同じ顧客が別のIDで入っている、コンバージョンの数え方が部署ごとに違う、といったことが起こります。
これを整えるSQLを、ダッシュボードやスプレッドシートの中にばらばらに書くと、同じ指標でもダッシュボードごとに数字が変わります。dbtを使うと、変換のSQLを1か所にまとめ、決まった順番で実行できます。SQLのファイルはGitで管理するため、変更の履歴も残ります。
dbtでできること
| 機能 | できること |
|---|---|
| モデル | SELECT文を1つのファイルに書くと、dbtがテーブルやビューとして作る |
| ref(依存関係) | ほかのモデルを ref で参照すると、dbtが依存関係を読み取り、正しい順番で作る(ref(別タブで開く)) |
| テスト | 「重複がない」「空がない」「決まった値しか入らない」「参照先に存在する」の4つを標準で確かめられる(Data tests(別タブで開く)) |
| ドキュメント・リネージ | モデルや列の説明を書き、どの表がどの表から作られているか(リネージ)を図で確かめられる(Documentation(別タブで開く)) |
| マクロ | よく使うSQLの部品を、関数のように使い回す(Jinjaという、SQLの中に条件分岐や繰り返しを書ける仕組みを使う) |
| シード | 変更の少ない小さなCSV(対応表など)をDWHに読み込む(Seeds(別タブで開く)) |
| スナップショット | 上書きされていく表の、過去の状態を記録する(Snapshots(別タブで開く)) |
| 増分の更新 | 2回目以降は新しい行だけを変換し、時間と費用を抑える(Incremental models(別タブで開く)) |
テストは、条件に合わない行を探すSELECT文として実行され、合わない行が0件なら合格です。たとえば「注文IDに重複がない」をテストにしておけば、取り込みの不具合で重複が入ったときに、ダッシュボードに出る前に気づけます。
マーケティングのデータでの使い方
Fivetranは、広告の媒体のデータを同じ形の表にまとめるdbtのパッケージ(Ad Reporting)を公開しています(dbt_ad_reporting(別タブで開く))。Google広告・Meta広告・TikTok広告などのデータを、1つの表で比べられる形に整えられます。
当社の支援でも、dbtで定義をそろえたテーブルを作り、ダッシュボードなどから同じ表を読む形にしています。媒体を横断した分析の例は、「広告の媒体横断分析をAIで行う方法(別タブで開く)」で紹介しています。
dbtの種類と名前(2026年10月時点)
dbt Labsのライセンスのページによると、2026年10月時点の製品の整理は次のとおりです(dbt Licensing FAQ(別タブで開く))。
| 名前 | 中身 | ライセンス | 料金 |
|---|---|---|---|
| dbt(v2) | 新しい世代の本体。以前の「dbt Fusion engine」 | dbt Product Licensing Agreement(dbt Labs独自のコードを含む) | 無料。人数の上限もない |
| dbt OSS(v2) | dbtのうち、オープンソースの部分だけを集めたもの | Apache 2.0 | 無料 |
| dbt Core(v1) | これまでのPython製のdbt | Apache 2.0 | 無料 |
| dbt platform | 画面で開発・実行・管理する有料のサービス | 商用の規約 | 下の表 |
ポイントは次の3つです。
- 「dbt Core」は、v2では使わない名前になった:dbt Labsは、v2では無料版も手元で動く版も両方の配布物にあるため、「dbt Core」の名前をやめたと説明しています。6月の合併の発表では「dbt Core v2.0」と呼ばれていたものが、9月に「dbt OSS」に改名されました
- v1はしばらく続く:今後出るdbt Core 1.13が、v1の最後のマイナー版になる予定です。dbt Labsは、安全に関わる修正を通常の1年より長く、3〜5年ほど続ける見込みとしています
- 手元で使うだけなら、dbt platformは要らない:無料のdbt(v2)は、dbt platformのアカウントなしで使えます。一部の機能は、無料のサインインで使えるようになります
dbt Labsは、ほとんどのチームに、オープンソースの部分だけの版より機能の多いdbt(v2)を勧めています。
Fivetranとの合併
2026年6月1日、Fivetranとdbt Labsは合併を完了しました。CEOはFivetranのGeorge Fraser氏、dbt Labsの創業者のTristan Handy氏がPresidentを務め、当面は「Fivetran + dbt Labs」として事業を行うとしています(Fivetranのプレスリリース(別タブで開く))。
データの取り込みのFivetranと、変換のdbtが、同じ会社の製品になりました。Fivetranについては「Fivetranとは(別タブで開く)」で解説しています。
dbt platformの料金
| プラン | 料金 | 開発者の席 | 月に作れるモデルの数 |
|---|---|---|---|
| Developer | 無料 | 1 | 3,000 |
| Starter | 1ユーザーあたり月100ドル | 最大5 | 15,000 |
| Enterprise | 個別の見積もり | 個別 | 100,000 |
| Enterprise+ | 個別の見積もり | 個別 | 100,000 |
出典:dbtの料金(別タブで開く)(2026年10月時点)
Starterからは、表の依存関係を画面で見るdbt Catalogや、指標を定義するSemantic Layerが使えます。Enterpriseからは、列の単位の依存関係や、SSOなどの管理の機能が加わります。
dbt platformを使わず、無料のdbtを自社のサーバーやGitHub Actionsなどで定期実行する方法もあります。その場合、実行の仕組みは自社で用意します。
Dataformとの違い
Google Cloudには、dbtと同じ役割のDataformというサービスがあります。
| dbt | Dataform | |
|---|---|---|
| 提供元 | Fivetran + dbt Labs | Google Cloud |
| 対応するDWH | BigQuery、Snowflake、Databricks、Redshiftなど | BigQuery |
| 変換の書き方 | SQL(+Jinja)。Pythonのモデルも書ける | SQLX(SQLを拡張した書き方)。JavaScriptで部品を使い回せる |
| テスト | 標準の4つと、自分で書くテスト | assertions(一意・空でない・独自の条件) |
| 料金 | 本体は無料。dbt platformは有料のプランあり | 無料。実行したクエリのBigQueryの料金や、定期実行に使うGoogle Cloudのサービスの料金はかかる(Dataformの料金(別タブで開く)) |
| 定期実行 | dbt platform、または自社で用意する | Google Cloudの中で設定できる |
BigQueryだけを使い、Google Cloudの中で完結させたいならDataformが手軽です。Snowflakeなどほかのデータウェアハウスも使う場合や、Fivetranのパッケージなど既製のdbtの資産を使いたい場合はdbtが向いています。
BigQueryでdbtを始める手順
手元のパソコンで、無料のdbt(v2)を使う場合の流れです(Install dbt(別タブで開く)、Connect BigQuery(別タブで開く))。
手順1:dbtをインストールする
Pythonの環境があれば、次のコマンドでインストールできます。Homebrew(macOS)などでも入れられます。手順は公式のページを参照してください。
python -m pip install dbtdbt --version で、インストールできたかを確かめます。
手順2:BigQueryの権限を用意する
dbtがBigQueryで使うアカウント(サービスアカウント=プログラムが使うGoogle Cloudのアカウント、または自分のGoogleアカウント)に、次のロールを付けます。公式のドキュメントでは、これが一般的な出発点とされています。
- BigQuery データ編集者(
roles/bigquery.dataEditor) - BigQuery ユーザー(
roles/bigquery.user) - BigQuery ジョブユーザー(
roles/bigquery.jobUser)
dbtは、変換したテーブルを作り直すため、テーブルの作成・削除の権限が必要です。元のデータとは別のデータセットに書き込むようにしておくと安全です。
手順3:プロジェクトを作り、接続を設定する
dbt init を実行すると、Google CloudのプロジェクトID、書き込み先のデータセット、データの場所(ロケーション)を聞かれ、そのあと認証の方法を選びます。認証は、サービスアカウントのJSONファイル、gcloudでの自分のGoogleアカウントでのログイン、Workload Identity連携(Microsoft Entra)から選べます。
設定は profiles.yml というファイルに保存されます。サービスアカウントを使う場合は、次のような形です。
default:
  target: dev
  outputs:
    dev:
      type: bigquery
      method: service-account
      keyfile: /path/to/key.json   # サービスアカウントの鍵のファイル
      database: your-project-id    # Google CloudのプロジェクトID
      schema: dbt_dev              # 書き込み先のBigQueryのデータセット
      location: asia-northeast1    # データの場所
      threads: 4                   # 同時に実行するクエリの数
ロケーションは、元のデータのデータセットと同じにします。違うと、クエリが失敗します。
手順4:モデルを書いて実行する
models のフォルダにSELECT文のファイルを置き、dbt build を実行すると、モデルの作成とテストが依存関係の順に実行されます。
最初は、1つのデータソース(たとえばGoogle広告)について、列の名前をそろえる整形のモデルと、日別の集計のモデルを作るところから始めます。
dbt platformで始める場合
dbt platformでは、画面からBigQueryの接続を作ります。公式のドキュメントでは、サービスアカウントのJSONキーをアップロードする方法が推奨されています(Connect BigQuery(別タブで開く))。
dbtのAIの機能
dbt Labsは、AIからdbtのプロジェクトを使うためのMCPサーバーを公開しています(About dbt MCP(別タブで開く))。ClaudeなどのAIから、モデルの定義や依存関係、指標を参照できます。MCPの仕組みは「MCPとは(別タブで開く)」で解説しています。
2026年10月時点で、dbt platformにはAIの機能が2つあります(dbt Copilot(別タブで開く))。
- dbt Copilot:SQL・テスト・ドキュメントを作る。Starter以上のプランで使える(無料のDeveloperは対象外)
- dbt Wizard:調べるところから、実装して確かめるところまでを行うAIエージェント。プレビュー版で、使った量に応じてクレジットが減る
AIにデータを分析させるときも、dbtで定義をそろえたテーブルを読ませれば、AIが指標ごとに違う計算方法で数字を出すことを減らせます。指標の定義を1か所にまとめる仕組みは「セマンティックレイヤーとは(別タブで開く)」で解説しています。
dbtを入れるべきか
dbtが役に立つのは、次のような状態のときです。
- DWHにデータは集まっているが、変換のSQLがダッシュボードやスプレッドシートに散らばっている
- 同じ指標なのに、レポートごとに数字が違う
- 担当者が替わると、どの表がどう作られているかわからなくなる
一方、まだデータをDWHに集めていない段階では、先に取り込みの仕組みを作ります。また、dbtはSQLを書く人がいてはじめて使えるツールです。社内にいない場合は、最初の設計とモデルの作成を外部に任せ、運用の中で少しずつ引き継ぐ方法もあります。
データ基盤全体の進め方は「データ基盤の構築の進め方(別タブで開く)」で、費用の目安は「データ基盤の費用の目安(別タブで開く)」で解説しています。
まとめ
- dbtとは:DWHの中のデータを、SQLのSELECT文で分析に使える形に変換するツール。ELTのT(変換)を担う
- できること:依存関係の管理、テスト、ドキュメント、増分の更新など。変換の定義を1か所にまとめられる
- 2026年の変化:6月にFivetranとdbt Labsの合併が完了。9月にdbt v2が正式版になり、「dbt」と「dbt OSS」の2つの配布物になった。v1のdbt Coreもしばらく続く
- 料金:dbtの本体は無料。管理画面つきのdbt platformは、Developerが無料、Starterが1ユーザーあたり月100ドル
- Dataformとの違い:BigQueryだけならDataformも選択肢。ほかのDWHや既製のパッケージを使うならdbt
株式会社INVOXは、データ基盤の構築、データ分析の支援、AIエージェントの開発を行っています。広告やGA4、CRMのデータをBigQueryに集め、dbtやDataformで定義をそろえたテーブルを作り、ダッシュボードやClaudeで使える環境までを支援しています。
「dbtを入れるべきか判断したい」「変換のSQLが散らばっていて、数字がそろわない」といった課題をお持ちでしたら、お問い合わせください。


