

データ基盤の構築は、①現状把握、②設計、③取り込み、④整形、⑤可視化とAIの接続、⑥運用、の順に進めます。従業員数十〜数百名の会社が、広告・GA4・CRMなど数種類のデータで最初の基盤を作る場合、最初のダッシュボードが動くまで2〜3か月が目安です。
構築の成否を分けるのは、ツールの選び方より、設計の段階で「誰が何を判断するか」「顧客をどのIDでつなぐか」「数字の定義をどこに書くか」を決めておけるかどうかです。
本記事では、データ基盤の構成、6つの手順と各段階で作るもの、期間の目安、設計で決めておくこと、必要な体制と、構築でつまずきやすい点を解説します。費用の内訳と試算は「データ基盤の費用の目安(別タブで開く)」で解説しています。
データ基盤とは
データ基盤とは、社内外に散らばったデータを1か所に集め、誰もが同じ定義の数字を使えるようにする仕組みです。
広告の成果は各媒体の管理画面、サイトの行動はGA4、商談はCRM、売上は決済や会計のシステムにあります。それぞれの画面では数字が見られても、「どの広告から来た顧客が、契約を続けているか」のように、複数のデータをまたぐ問いには答えられません。データ基盤は、この問いに答えるための土台です。
データ基盤の構成
データ基盤は、次の4つの役割でできています。
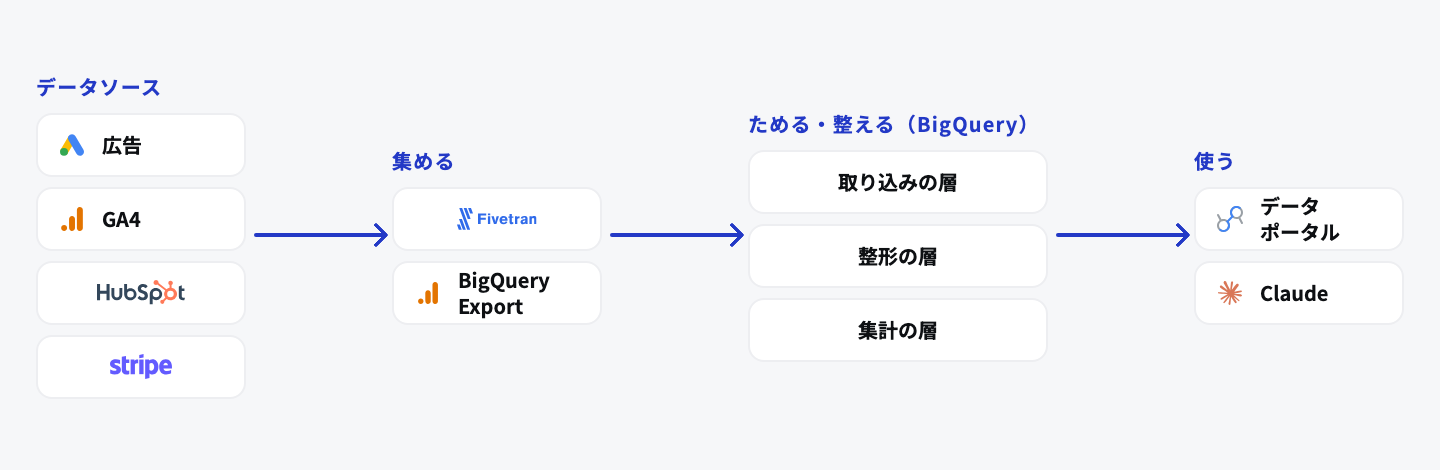
| 役割 | すること | 主なツールの例 |
|---|---|---|
| 集める | 各ツールのデータを、決まった間隔で自動で取り込む | Fivetran、GA4・Search ConsoleのBigQueryへの書き出し |
| ためる | 取り込んだデータを保存し、SQLで集計できるようにする | BigQuery |
| 整える | 表記・粒度・定義をそろえ、分析に使う表を作る | Dataform、dbt |
| 使う | ダッシュボードで見る、AIに質問して分析する | データポータル(旧Looker Studio)、Claudeなどの生成AI |
GA4とSearch Consoleは、Googleの公式機能でBigQueryに直接書き出せます。BigQueryのようなデータウェアハウスの役割は「データウェアハウス(DWH)とは(別タブで開く)」で解説しています。広告媒体やCRMのデータは、Fivetranなどのデータ統合ツールで取り込むのが一般的です。Fivetranについては「Fivetranとは?できること・料金・始め方(別タブで開く)」で解説しています。顧客のデータを集めてメールや広告に使う仕組み(CDP)との違いは「CDPとは(別タブで開く)」で整理しています。
「整える」の段階では、取り込んだままの表を直接使わず、次の3つの層に分けて表を作ります。
| 層 | 中身 | 誰が読むか |
|---|---|---|
| 取り込みの層 | 各ツールから取り込んだままの表 | 整える処理だけ |
| 整形の層 | 列名・型・表記をそろえ、重複を除いた表 | 集計の処理 |
| 集計の層 | 「媒体別・日別の費用とCV」など、使う目的ごとに集計した表 | ダッシュボード、AI、各部門の担当者 |
ダッシュボードやAIが集計の層だけを読むようにしておくと、定義が1か所にまとまり、BigQueryの処理量も抑えられます。
データ基盤の構築の6つの手順
手順1:現状把握
今あるデータと、今の集計のやり方を棚卸しします。
| 調べること | 例 |
|---|---|
| どのツールに、どのデータがあるか | Google広告・Meta広告、GA4、HubSpot、Stripe |
| 誰が、何の数字を、どう集計しているか | マーケティング担当者が毎週月曜日に、管理画面のCSVをスプレッドシートで突き合わせている |
| 数字の食い違い | 広告の管理画面とGA4とで、CVの数が合わない |
| 権限と個人情報 | 誰がどのデータを見てよいか、氏名やメールアドレスを含むか |
作るもの:データの棚卸しの一覧、着手する順番の案
期間の目安:1〜2週間
手順2:設計
誰が何を判断するために、どの数字を見るかを決め、そこから必要な表を逆算します。決めておくことは、次の章で詳しく解説します。
最初に取り込むデータは、優先度の高い2〜3種類に絞ります。一度にすべてを作ろうとすると、成果が見える前に費用と時間がかさみます。
作るもの:指標と集計の定義書、表の一覧と項目、ダッシュボードの画面のイメージ
期間の目安:2〜3週間
手順3:取り込み
設計で決めたデータを、決まった間隔で自動で取り込む設定をします。
- 広告媒体・CRM・決済など:データ統合ツールのコネクタを設定する
- GA4・Search Console:BigQueryへの書き出しを有効にする
- 自社のデータベースやスプレッドシート:データ統合ツール、またはBigQueryの機能で取り込む
取り込みを始めたら、各ツールの管理画面の数字と、BigQueryに入った数字が合うかを確かめます。広告媒体のCVのように、後から数字が書き換わるデータは、どこまでさかのぼって取り直すかも決めます。
手順4:整形
取り込みの層から、整形の層と集計の層の表を作ります。
整形と集計の処理は、DataformやdbtにSQLとして書きます。SQLとして書いておけば、定義の変更の履歴が残り、担当者が替わっても同じ数字が出ます。表どうしの依存関係を管理し、決まった時刻に順番に更新することもできます。dbtの機能と始め方は「dbtとは(別タブで開く)」で解説しています。
手順5:可視化とAIの接続
毎日・毎週決まって見る数字はダッシュボードにし、その場の疑問はAIに質問して確かめる、と使い分けます。
ClaudeなどのAIをBigQueryにつなぐと、SQLを書かずに日本語で質問して集計できます。このときも、AIには集計の層の表と、指標の定義を渡します(「ClaudeとBigQueryを連携する方法(別タブで開く)」)。
使い始めの1〜2週間は、ダッシュボードの数字を、これまでの集計と並べて確かめます。数字が合うと確かめられてから、これまでの集計をやめます。
作るもの(手順3〜5):取り込みの設定、整形と集計のSQL、ダッシュボード、運用の手順書
期間の目安(手順3〜5):1〜2か月
手順6:運用
データ基盤は、作って終わりではありません。次のことを、毎月の決まった作業にします。
- 取り込みの監視:取り込みが止まっていないか、件数が急に減っていないか
- 定義の見直し:施策や組織が変わったときに、指標の定義を直す
- データの追加:次に優先度の高いデータを、手順2から同じ流れで加える
- 費用と権限の管理:BigQueryの処理量の上限、部門・役割ごとの権限
設計で決めておく6つのこと
構築の後から変えると手戻りが大きいのは、次の6つです。
| 決めること | 例 | 決めていないと起きること |
|---|---|---|
| 目的と見る数字 | マーケティングは媒体別の商談数で予算配分を決める | 使われない表に、取り込みと集計の費用がかかり続ける |
| 顧客をつなぐID | 申込時の顧客IDを、CRMと決済のデータにも持たせる | 広告から契約・継続までを、顧客単位でつなげない |
| 粒度 | 広告は日別・広告単位、決済は請求単位 | 後から細かく見たくなっても、取り込み直すしかない |
| 指標の定義 | 「CV」は申込の完了。重複と社内のテストを除く | 部門ごとに数字が合わず、数字合わせに時間を取られる |
| 更新の頻度 | 広告とGA4は毎朝、CRMは1時間ごと | 必要以上に頻繁に更新し、費用がかさむ |
| 権限と個人情報 | 個人情報を含む表は、CSの担当者だけが見られる | 見てはいけない人に、氏名や連絡先が見える |
特に、顧客をつなぐIDは、データ基盤の外で決める必要があることが多くあります。たとえば、申込フォームで発行したIDをCRMや決済のシステムにも登録する、といった業務やシステムの側の変更が要るためです。
権限は、データ基盤につなぐBIツールの側でも決めておきます。BIツールが狙われた2026年の不正アクセスと、見直す点は「Metabaseの脆弱性と、BIツールからの情報漏えいを防ぐために見直すこと(別タブで開く)」で解説しています。
期間の目安
当社がマーケティングのデータ基盤を支援するときの期間の目安は、次のとおりです。主要な広告媒体のデータが取れる場合を想定しています。
| 段階 | 期間の目安 | 作るもの |
|---|---|---|
| 現状把握 | 1〜2週間 | 媒体とデータの棚卸し、着手する順番の案 |
| 設計 | 2〜3週間 | 指標と集計の定義書、ダッシュボードの画面のイメージ |
| 実装(取り込み・整形・可視化) | 1〜2か月 | 統合されたデータとダッシュボード、運用の手順書 |
| 定着 | 継続 | 利用状況と成果の振り返り、改善 |
期間が延びやすいのは、顧客をつなぐIDがない場合や、広告の計測の設定がそろっていない場合です。この場合は、実装の前に、IDの持たせ方や計測の命名規則を整えます。
株式会社Techouse様では、GA4と広告のデータに絞って始め、使い始めて1〜2か月で、主要なKPIを社内で決めた指標に沿って継続的に見られる状態になりました(「毎朝1時間の広告データ取り込みを15〜20分に(別タブで開く)」)。
必要な体制
データ基盤の構築には、次の役割が必要です。1人が複数の役割を兼ねても構いません。
| 役割 | すること |
|---|---|
| 責任者 | 目的と優先順位を決め、部門間の定義の違いを調整する |
| データを使う各部門の担当者 | 見たい数字と判断を伝え、出来上がった数字を確かめる |
| データエンジニア | 取り込みの設定、整形と集計のSQL、監視 |
| データアナリスト | 指標の定義、ダッシュボードの設計、分析 |
社内にデータエンジニアがいない場合、取り込みと整形の部分を外部に任せることが多くあります。ただし、目的と定義を決める責任者は、社内に置く必要があります。外部に任せる場合も、SQLと定義書を社内に残し、社内の担当者が自分でデータを引き出せる状態を目指します。
内製と外部支援の分け方は「データ基盤の費用の目安(別タブで開く)」で、外注先の選び方は「データ分析を外注するときの支援会社の選び方(別タブで開く)」で解説しています。
構築でつまずきやすい点
取り込んだままの表を、ダッシュボードで直接読む
取り込みの層の表をダッシュボードやAIが直接読むと、定義がダッシュボードの数だけ散らばります。読むデータ量も増え、BigQueryの費用がかさみます。集計の層の表を読むようにします。
定義をダッシュボードの中に書く
CVや売上の計算式を、ダッシュボードの計算フィールドやスプレッドシートの数式に書くと、同じ指標でもダッシュボードごとに数字が変わります。定義はDataformやdbtのSQLに1か所だけ書きます。
取り込みが止まっても気づかない
広告媒体の認証が切れる、APIの仕様が変わるなどで、取り込みが止まることがあります。止まったまま数日たつと、その間の数字で判断することになります。取り込みの失敗の通知と、件数の急な変化を確かめる仕組みを、最初から用意します。
作ったが使われない
設計の段階で、各部門の担当者が見たい数字を聞いていないと、出来上がっても使われません。最初のダッシュボードは、今いちばん手作業で集計している数字から作ると、効果が分かりやすく、使われやすくなります。
事例:別々のシステムの行動データと車両データを統合したDeNA SOMPO Mobility様
個人間カーシェアサービス「Anyca」を運営する株式会社DeNA SOMPO Mobility様では、ユーザーの行動データと車両データが別々のシステムにあり、掛け合わせた分析ができていませんでした。
両方のデータをBigQueryに集め、Dataformで粒度と命名をそろえて、ユーザーの軸でも車両の軸でも同じ意味で読める表を作りました。データポータルのダッシュボードで、マーケティング部門が最新のデータを自分で見られる状態になっています。
詳細は「集計の手作業をなくし、マーケターが最新の統合データを見られる状態に(別タブで開く)」をご覧ください。
まとめ
- データ基盤は、集める・ためる・整える・使うの4つの役割でできている。整える段階では、取り込み・整形・集計の3つの層に分ける
- 構築は、現状把握、設計、取り込み、整形、可視化とAIの接続、運用の6つの手順で進める。最初のダッシュボードが動くまで2〜3か月が目安
- 設計では、目的と見る数字、顧客をつなぐID、粒度、指標の定義、更新の頻度、権限と個人情報の6つを先に決める
- 目的と定義を決める責任者は社内に置き、取り込みと整形は外部に任せることもできる
株式会社INVOXは、データ基盤の構築、データ分析の支援、AIエージェントの開発を行っています。サブスク・SaaSなど継続課金の事業向けに、広告・サイト・申込・決済・CRMのデータを1つに統合し、獲得から継続率・LTVまでを、SQLを書かずにAIに尋ねて分析できる環境を構築しています。
「データ基盤を作りたいが、どのデータから始めればよいか分からない」「顧客のIDがつながっておらず、広告から継続までを追えない」といった課題をお持ちでしたら、お問い合わせください。


