

セマンティックレイヤーは、売上・MRR・解約率などの指標の定義を1か所にまとめ、ダッシュボードやAIが同じ定義で答えるようにする仕組みです。データウェアハウス(DWH)のテーブルと、データを使う人やツールの間に置きます。
dbt Labsは、セマンティックレイヤーを使うと、既存のモデルの上に指標を定義でき、結合も自動で処理されるため、同じ処理を何度も書かずに済む、と説明しています(dbt Semantic Layer(別タブで開く))。
生成AIにデータを分析させる場面が増え、セマンティックレイヤーへの関心が高まっています。AIがSQLを書くときに、指標の定義を推測させずに済むためです。
本記事では、セマンティックレイヤーが必要になる理由、主な製品、AIの正答率への効果、小さく始める方法を解説します。記載の仕様は2026年10月時点の公式情報に基づきます。
セマンティックレイヤーとは
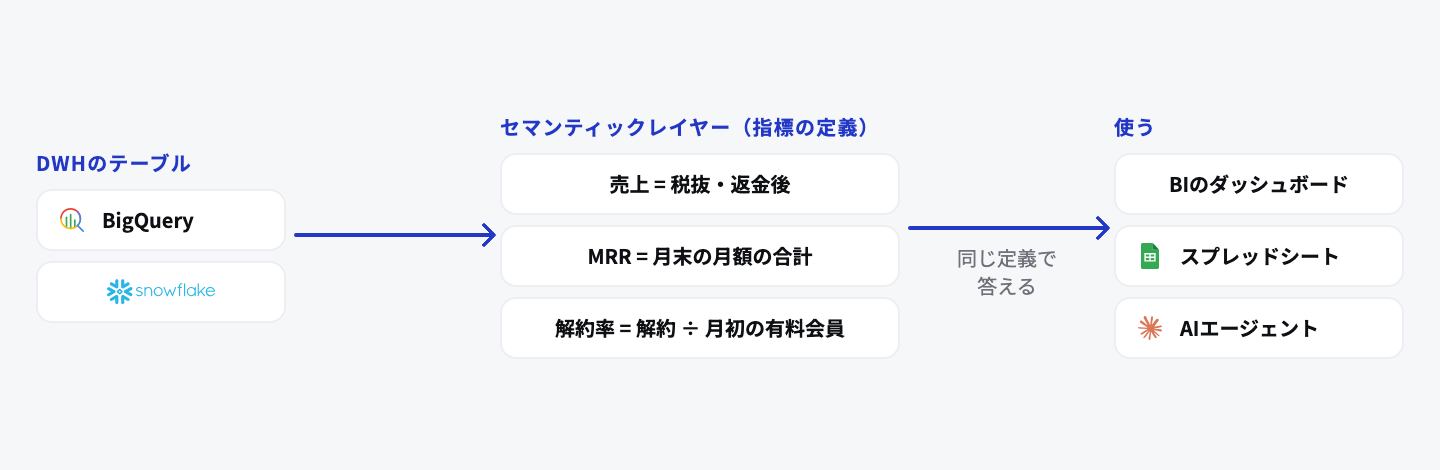
「セマンティック(semantic)」は「意味の」という意味です。DWHのテーブルは、列の名前と値しか持っていません。amount という列が税込か税抜か、返金を引いた後か、テーブルを見ただけでは分かりません。
セマンティックレイヤーには、次のような「意味」を書きます。
| 書くもの | 例 |
|---|---|
| 指標の計算式 | 売上 = 請求額(税抜)の合計 − 返金 |
| 対象と除外 | 社内のテスト用のアカウントは除く。トライアル中の会員は有料会員に含めない |
| 集計の単位 | MRRは月末の時点。解約率は月初の有料会員を分母にする |
| テーブルのつなぎ方 | 請求のテーブルと顧客のテーブルは customer_id でつなぐ |
| 切り口(ディメンション) | プラン、獲得チャネル、登録月で分けられる |
ダッシュボードやAIは、テーブルを直接読む代わりに、このレイヤーに「プラン別の4月のMRR」のように問い合わせます。計算はレイヤーが定義どおりに行います。
なぜ必要になるのか
部署によって数字が違う
同じ「売上」でも、経理は税抜・返金後、営業は契約の金額、マーケティングは決済の画面の金額、というように、定義が部署で違うことがあります。会議で数字が合わず、どれが正しいかを確かめるのに時間がかかります。
ダッシュボードごとにSQLを書くと、同じ指標の計算が何か所にも散らばります。定義を変えたときに、一部だけ直し忘れることも起きます。
AIが定義を推測してしまう
生成AIに「先月の解約率は?」と尋ねると、AIはテーブルの列の名前から、計算の方法を推測してSQLを書きます。分母を月初の会員にするか月末にするか、休止を解約に含めるかは、テーブルを見ても分かりません。
AIの答えは、もっともらしい形で返ってくるため、定義の違いに気づきにくいのが問題です。セマンティックレイヤーで定義を決めておけば、定義した指標については、AIは計算の方法を推測せず、決められた定義で答えます。
AIの正答率への効果
dbt Labsのベンチマーク(2026年4月)
dbt Labsは、下のdata.worldの研究と同じ保険のデータ(15テーブル)を使い、11の質問を、それぞれ20回ずつ、生成AIに答えさせて正答率を比べました(Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update(別タブで開く))。
| 方法 | 2023年(GPT-4) | 2026年(Claude Sonnet 4.6・GPT-5.3 Codex) |
|---|---|---|
| AIがテーブルから直接SQLを書く(text-to-SQL) | 32.7% | 64.5% |
| セマンティックレイヤーを通す | 60.5% | 72.7% |
セマンティックレイヤーで定義されている範囲の質問に限ると、2026年は、セマンティックレイヤーを通した場合の正答率が100%でした。直接SQLを書いた場合は51.2〜62.5%です。
一方で、定義されていない範囲の質問(多くのテーブルをたどる必要があるもの)には、セマンティックレイヤーでは答えられませんでした。ただし、そのときは誤った数字を返さず、答えられないことを返します。AIが直接書くSQLは、間違えるときも、もっともらしい数字を返します。
dbt Labsが勧める進め方は、次の順です。
- まずセマンティックレイヤーで答えられるかを確かめる
- 答えられなければ、小さなモデル(テーブル)を足して埋められるかを確かめる
- それでも埋められない探索的な質問は、AIが直接書くSQLで答える
ベンチマークでも、最小限のモデルを3つ足すと、セマンティックレイヤーで答えられる範囲が広がりました。
そのほかの調査
- data.worldの研究(2023年):GPT-4に保険のデータの43問を答えさせ、SQLを直接書かせた場合の正答率は16.7%、データの意味をナレッジグラフで与えた場合は54.2%でした(arXiv 2311.07509(別タブで開く))。セマンティックレイヤーそのものではなく、データの意味を与える方法の研究です
- Google Cloudは、社内のテストで、Lookerのセマンティックレイヤーを使うと、生成AIへの自然言語の質問で、データの誤りが最大で3分の2減った、としています(Google Cloud Blog(別タブで開く))。テストの条件は公開されていません
AIのモデルが良くなり、直接SQLを書かせた場合の正答率も上がっています。それでも、毎月の報告に使う指標のように、間違いが許されない数字では、定義を決めておく価値は変わりません。
主な製品(2026年10月時点)
| 製品 | 概要 | 提供状況 |
|---|---|---|
| dbt Semantic Layer(MetricFlow) | dbtのモデルの上に指標を定義する。MetricFlowは2025年10月にApache 2.0でオープンソース化 | dbt platformのStarter以上のプランで利用。Snowflake・BigQuery・Databricks・Redshift・Postgres・Trinoに対応 |
| Looker(LookML) | LookerのモデリングのレイヤーのLookMLで、指標と結合を定義する | Lookerの会話型分析(2025年11月に一般提供)は、LookMLの定義をもとに答える |
| Snowflake セマンティックビュー | データベースのオブジェクトとして、指標と結合を保存する | 2025年6月に一般提供。Cortex Analyst(自然言語でのデータの問い合わせ)が、この定義を読んでSQLを作る |
| Databricks Unity Catalog Business Semantics | 指標の定義(Metric Views)をUnity Catalogで管理する | 2026年4月に一般提供。Genieスペースから使える |
| Cube | BI・アプリ・AIエージェントが共通で使うセマンティックレイヤー | オープンソース版(Cube Core)と商用版がある |
| Power BI セマンティックモデル | Power BIの中で、指標と関係を定義する | 2023年11月に「データセット」から名称を変更 |
出典:MetricFlowのオープンソース化(別タブで開く)、dbt Semantic Layerの設定(別タブで開く)、Looker 会話型分析(別タブで開く)、Snowflake セマンティックビュー(別タブで開く)、Snowflake リリースノート(別タブで開く)、Databricks(別タブで開く)、Cube(別タブで開く)、Power BI(別タブで開く)
なお、dbt Labsは2026年6月にFivetranとの合併を完了しています(dbt Labs(別タブで開く))。dbtそのものについては「dbtとは(別タブで開く)」で解説しています。
BigQueryで使えるものには、Looker、dbt Semantic Layer、Cubeなどがあります。BigQueryの会話型分析は、Lookerと組み合わせると、LookMLの指標の定義をもとに答えます(Google Cloud Blog(別タブで開く))。
定義の書き方を共通にする動き:Apache Ossie
製品ごとに定義の書き方が違うと、ツールを変えるたびに定義を書き直すことになります。そこで、2025年9月に、Snowflake・Salesforce・dbt Labsなど17社が、定義の書き方を共通にする「Open Semantic Interchange(OSI)」を発表しました(Snowflake(別タブで開く))。
2026年1月に最初の仕様が公開され、Databricksなども加わりました(Snowflake(別タブで開く))。その後、2026年7月にApacheソフトウェア財団のインキュベーターに入り、名前は「Apache Ossie」になりました(Apache Ossie(別タブで開く))。
小さく始める方法
セマンティックレイヤーの製品を入れる前に、できることがあります。
1. 重要な指標を5〜10個に絞り、定義を書く
まず、経営会議や毎月の報告で使う指標を5〜10個選びます。サブスクなら、MRR、有料会員数、解約率、有料転換率、LTVなどです。指標ごとに、上の表の「指標の計算式・対象と除外・集計の単位」を文章で書きます。
MRRの定義は「MRRとは(別タブで開く)」、解約率の分母の決め方は「チャーン分析のやり方(別タブで開く)」、指標の分解は「KPIツリーの作り方(別タブで開く)」で解説しています。
2. 定義をDWHのテーブルにする
定義した指標を、dbtなどでDWHのテーブル(たとえば月ごと・顧客ごとのMRRのテーブル)として作っておきます。ダッシュボードやAIは、元のテーブルではなく、このテーブルを読むようにします。これだけでも、計算が1か所にまとまります。
3. AIには定義を前提として渡す
Claudeなどで分析するときは、指標の定義を書いた文書と、使ってよいテーブルの一覧を、毎回の前提として渡します。Claudeのスキルやプロジェクトの指示に入れておけば、毎回書く必要はありません。
渡し方の例は、「カスタマーサクセスのKPIの決め方(別タブで開く)」の「定義を前提として渡す」の節で紹介しています。
4. 使う人とツールが増えたら、製品を検討する
ダッシュボードのツールが複数ある、AIで分析する人が増えた、指標の数が増えて文書では管理しきれない、といった段階になったら、セマンティックレイヤーの製品を検討します。今使っているDWHとBIのツールに合わせて選びます。
セマンティックレイヤーを入れるときの注意点
定義を決めるのは、ツールではなく人
どの製品を使っても、「解約率の分母は何か」を決めるのは事業の担当者です。定義が決まらないままツールを入れても、数字はそろいません。経理・営業・マーケティングで定義を話し合い、決めた理由も残します。
すべての質問には答えられない
dbt Labsのベンチマークのとおり、定義していない指標や切り口の質問には答えられません。探索的な分析は、AIに直接SQLを書かせるなど、別の方法と組み合わせます。
定義の変更を管理する
定義を変えると、過去の数字も変わります。いつ、誰が、なぜ変えたかを記録し、変更前の数字と比べられるようにしておきます。dbtのように、定義をコードとして管理できる製品なら、Gitで変更の履歴を残せます。
まとめ
- セマンティックレイヤー:指標の定義を1か所にまとめ、BIやAIが同じ定義で答えるようにする仕組み
- 必要になる理由:部署ごとに数字が違う問題と、AIが定義を推測してしまう問題を防ぐ
- AIへの効果:dbt Labsの2026年のベンチマークでは、定義した範囲の質問の正答率が100%。定義していない質問には答えられないため、直接SQLを書かせる方法と使い分ける
- 主な製品:dbt Semantic Layer、Looker(LookML)、Snowflake セマンティックビュー、Databricks、Cube、Power BI。書き方を共通にするApache Ossie(旧OSI)も進んでいる
- 始め方:重要な指標を5〜10個に絞って定義を書き、DWHのテーブルにし、AIには定義を前提として渡す
株式会社INVOXは、データ基盤の構築、データ分析の支援、AIエージェントの開発を行っています。指標の定義を整理し、BigQueryとdbtで同じ定義の数字を出す仕組みを作り、AIで正しく分析できる状態を作る支援をしています。
「部署ごとに数字が合わない」「AIで分析させたいが、答えが正しいか不安」といった課題をお持ちでしたら、お問い合わせください。


